Veriyi bağla.Bağlamı yönet.Yapay zekâyı besle.
DataFloem; entegrasyonu, dönüşümü, kataloglamayı ve sorgulamayı Kubernetes üzerinde bir araya getirir. Akışları tuval üzerinde ya da Python ile kurun; genel bulutta, özel bulutta ya da kurum içinde çalıştırın ve verinizi açık formatlarda tutun.
Bankacılık, perakende, otomotiv ve sanayideki ekiplerin arkasındaki veri platformu.
Verinizin zaten bulunduğu yerden başlayın.
Eski veri tabanlarından nesne depolamaya ve lakehouse kataloglarına kadar her sistemi bir kez bağlayın ve tüm projelerde yeniden kullanın. Hangi ekiplerin her kaynağı okuyup yazabileceğine yöneticiler karar verir.
RDBMS
PostgreSQLOracleSQL ServerAzure SQLAzure SynapseMySQLTeradataVerticaClickHouseTrino
Bulut Veri Tabanı
BigQuery
Bulut Depolama
Azure Data Lake Storage Gen2Azure Blob StorageGoogle Cloud Storage
Nesne Depolama
Amazon S3S3 uyumlu depolar
NoSQL
MongoDBElasticsearch
Katalog
Iceberg REST kataloglarıJDBC kataloglarıDosya katalogları
Python Betiği
Python ile erişebildiğiniz her sistem
- FormatlarSnappy veya Gzip ile CSV, Parquet, ORC, JSON
- OkumaTam veya artımlı, kendi artım betiğinizle
- YazmaEkleme veya üzerine yazma, ön ve son sorgularla
- BağlantılarSSL/TLS ve sürücü seçenekleri, gizli bilgiler maskeli
Akışı çiz. Satırları oku. Kaymayı yakala.
Yeni bir entegrasyonu sıfırdan yazmak yerine görsel bir tuval üzerinde kurun. Her düğüm tiplendirilmiş bir form açar; böylece uyumsuz bir birleştirme anahtarı iş hata verdiğinde değil, siz kurarken ortaya çıkar.
- Versiyonlar. Her iş numaralı versiyonlar tutar; çalışan versiyonu kaybetmeden bir akışı değiştirebilirsiniz.
- Kopyala, yapıştır, grupla ve not ekle. Büyük bir işi büyük bir dosya gibi düzenleyin.
- Akış parametreleri. Sabit ya da ifade değerleri, herhangi bir alanda $$name olarak kullanılır.
- Otomatik yerleşim ve geri alma. Tek tıkla grafik düzenlenir ve elli adıma kadar geri alabilirsiniz.
- Kaynak ve HedefHer bağlayıcı ailesi, okuma ve yazma.
- SeçimKolonları tutun, yeniden adlandırın veya çıkarın.
- İfadeSpark söz dizimiyle hesaplanan kolonlar.
- Filtreİç içe kurallar ve koşul grupları.
- BirleştirmeLeft, right, full outer ve cross; tiplendirilmiş kurallarla.
- ToplamaSum, avg, min, max, count, distinct count, std dev.
- BirleşimUnion veya Union All; uyumsuzluklar kolon bazında gösterilir.
- TekilleştirmeTüm kolonlarda ya da seçtiklerinizde.
- SıralamaArtan veya azalan anahtarlar.
- Yeniden BölümlemeBölüm sayısı ve bölümleme kolonları.
- ÖrneklemeRastgele veya tabakalı; iki çıktı da korunur.
- SQLAdımı bir sorgu olarak yazın, çıktısını tanımlayın.
- WranglerCanlı taslak çalıştırmalı temizlik adımları.
- PythonBir veya daha fazla çıktı tablosu üreten betik adımı.
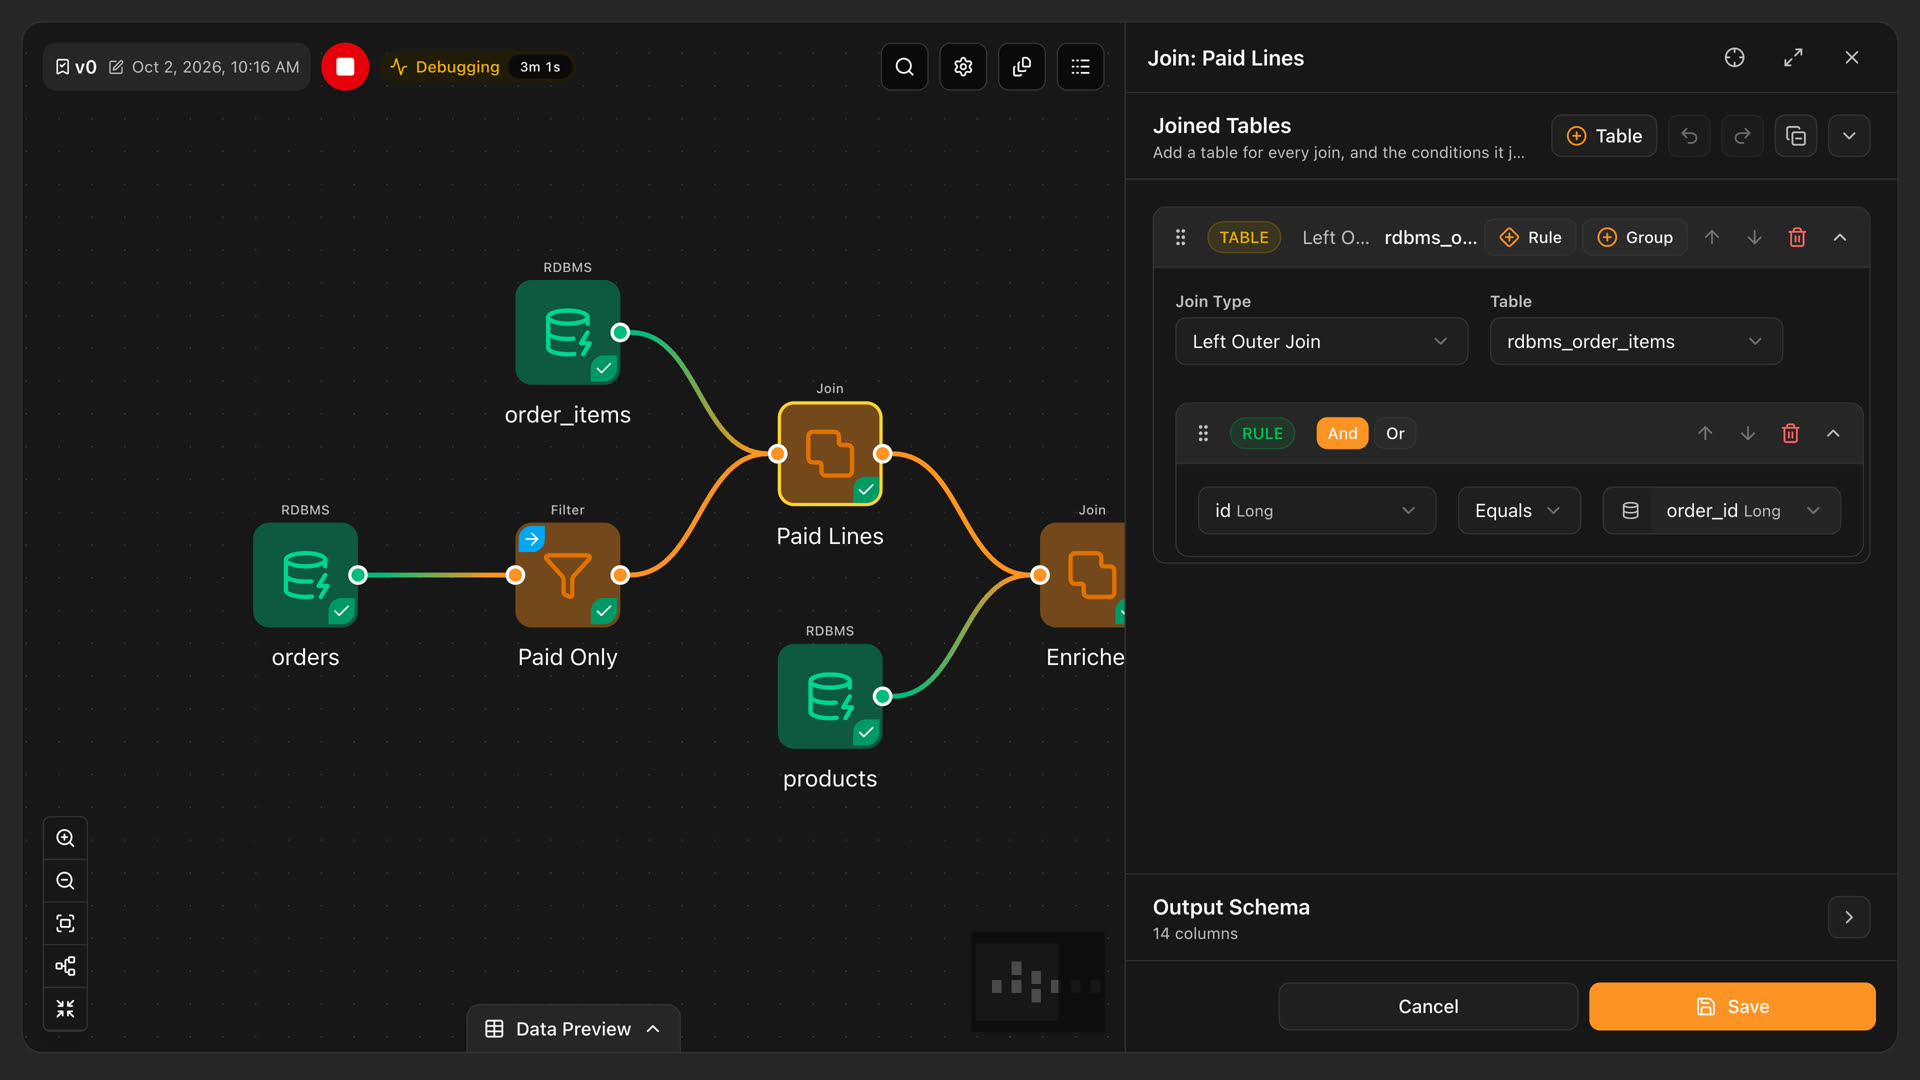
Okunabilen birleştirmeler.
Bir tablo ekleyin, birleştirme tipini seçin ve koşulu kurallar ile gruplardan oluşturun. Her kolon adının yanında tipini gösterir; böylece bir anahtar uyumsuzluğu motora ulaşmadan görünür. Çıktı şeması, kolon sayısıyla birlikte panelin altında yer alır.
Her düğümde satırları kontrol edin.
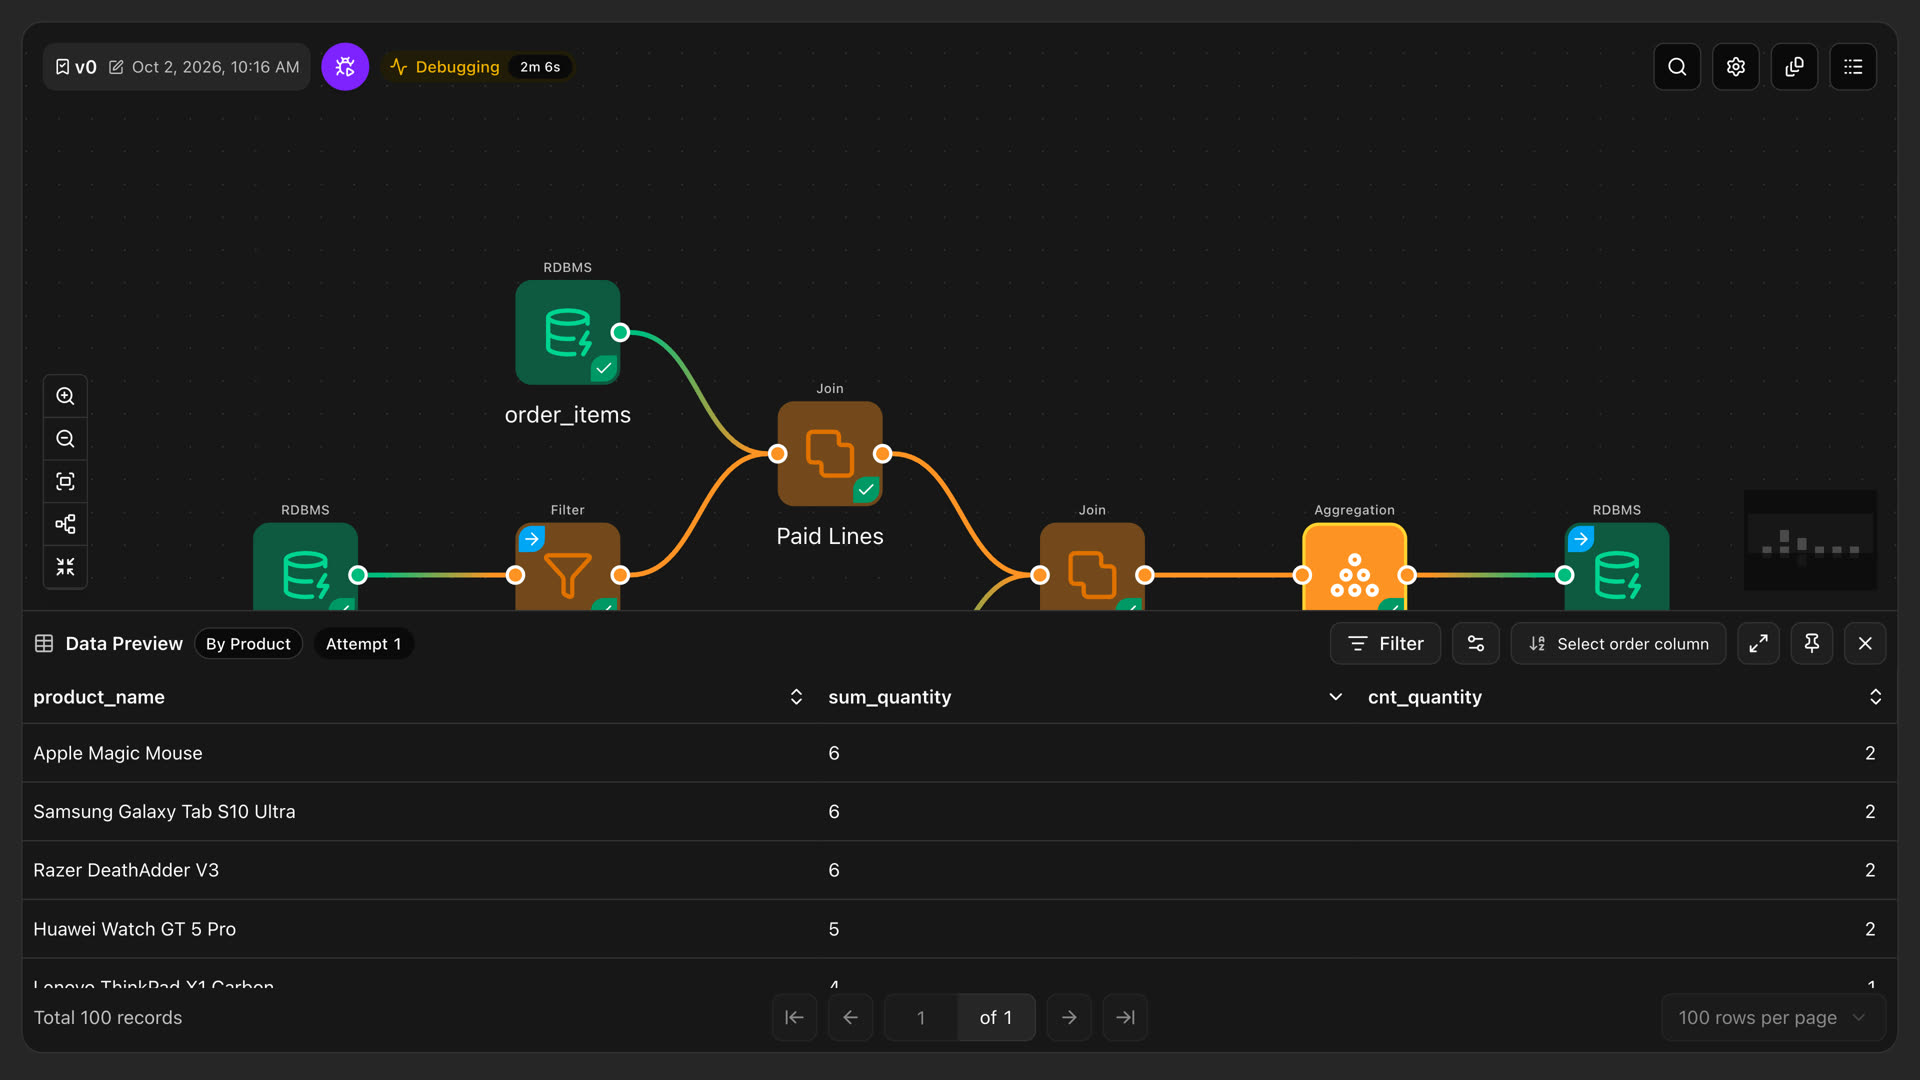
Akışı üzerinde çalıştığınız düğüme kadar çalıştırın ve satırlarını yerinde açın. Tuvalden ayrılmadan sonucu filtreleyin, sıralayın ve sayfalar arasında gezinin.
- Kısmi çalıştırma. İlgilendiğiniz düğümleri seçin ve yalnızca onları çalıştırın.
- Öncesini ve sonrasını karşılaştırın. Her hata ayıklama çalıştırması kendi önizlemesini tutar; böylece değişikliğinizin etkisini görebilirsiniz.
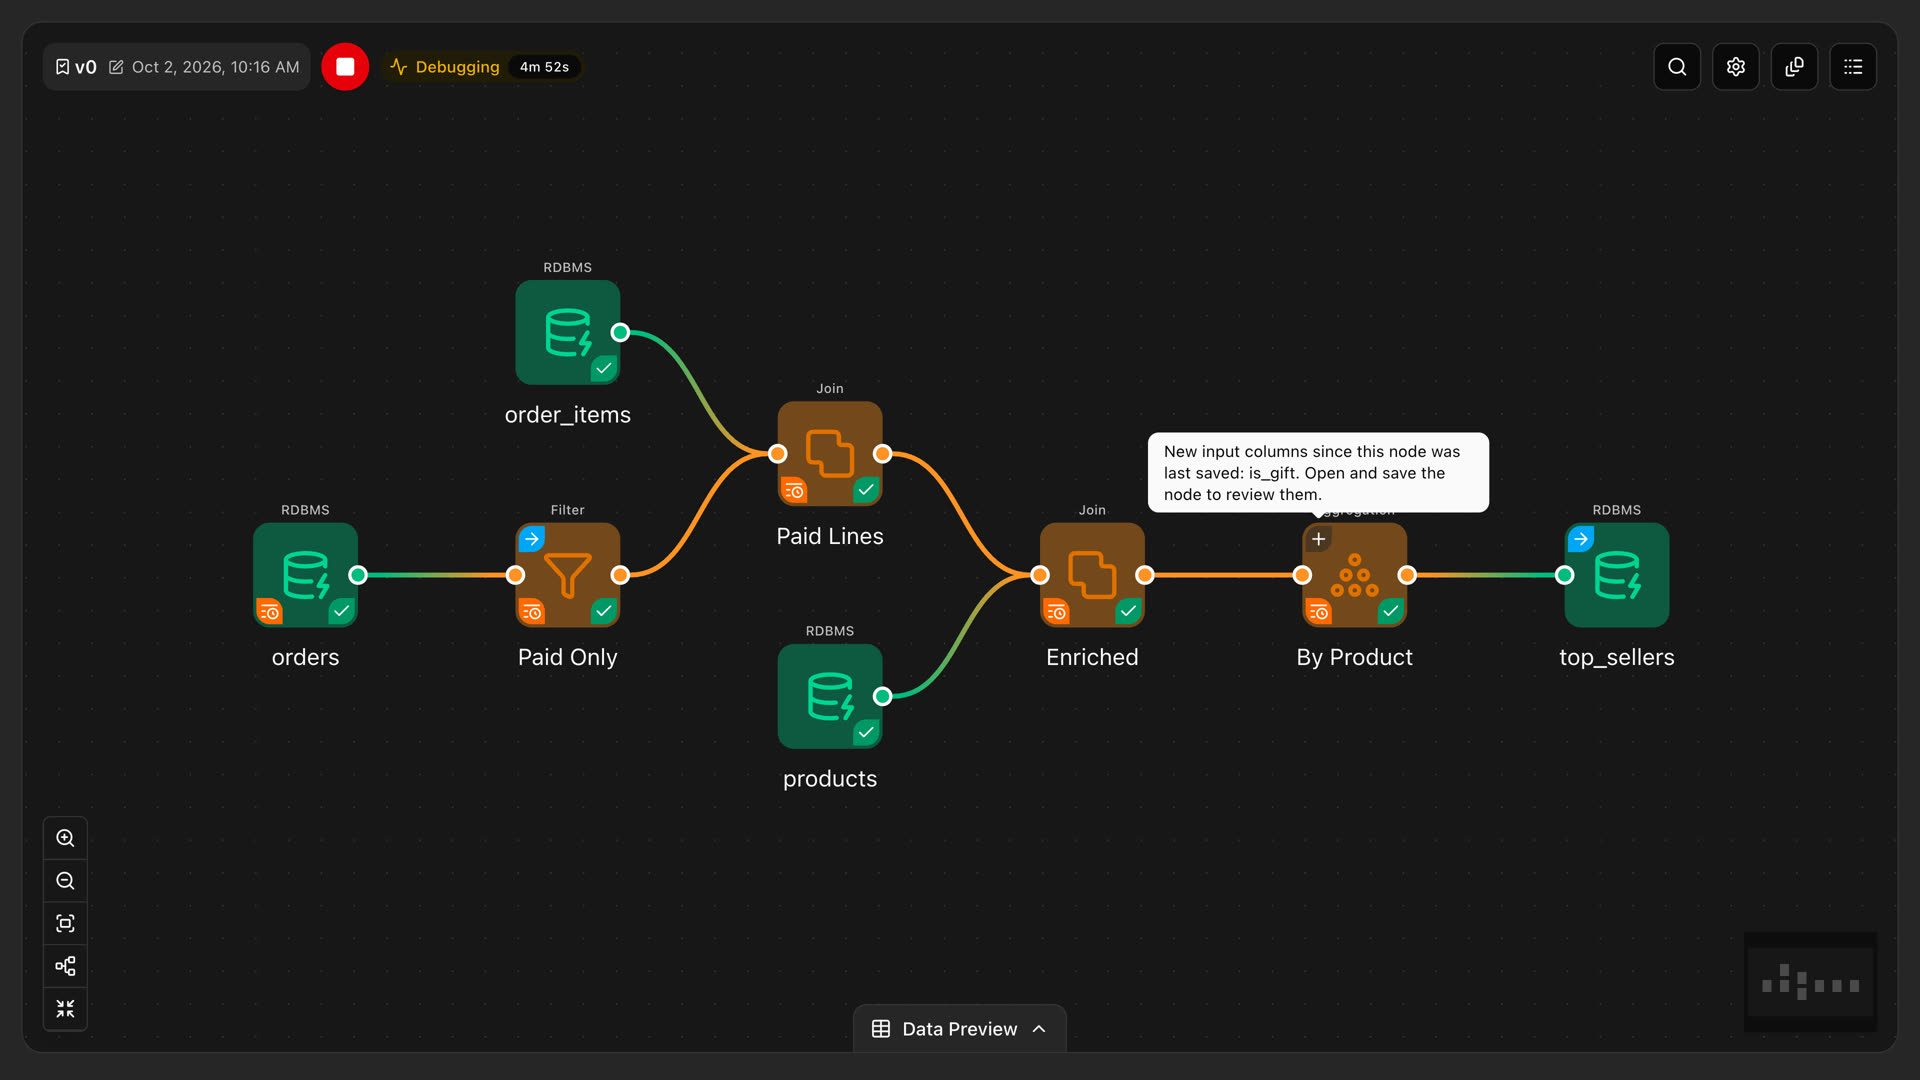
- Durum düğümün üzerinde. Çalışıyor, tamamlandı ve başarısız durumları tuvalde görünür. Son çalıştırmadan bu yana ayarları, bağlantıları veya öncülleri değişen düğüm güncel değil olarak işaretlenir.
Kaynakta bir kolon değişir. Yalnızca etkilenen düğümler inceleme ister.
Onlarca kaynak kendi takvimine göre değişirken şema değişiklikleri günlük bir gerçektir. Her düğüm kaydedildiği andaki kolonları hatırlar. Bir kaynağa kolon eklendiğinde, kaynaktan kolon çıkarıldığında ya da kolonun tipi değiştiğinde DataFloem yalnızca değişikliğin ulaştığı düğümleri işaretler. Değişikliğin ne anlama geldiğine siz karar verirsiniz.
Bir kaynak değişir.
Bir kolonun yalnızca yeri değiştiyse DataFloem referansı sizin için düzeltir. Çıktısı değişebilecek düğümler, kolonları tam adıyla belirten bir işaret alır.
Tuval onu takip eder.
Yalnızca yeri değişen kolon kimlikleri sizin için onarılır. Anlamı değişebilecek düğümler, ipucunda tam kolon adlarıyla birlikte bir işaret alır.
Bir kişi onaylar.
Düğümü açın ve seçin: yeni kolonları çıktıya ekleyin ya da dışarıda bırakın. İncelemeler açıkken tam çalıştırma sizi uyarır.
Bazı işler koda aittir. Onları aynı projede tutun.
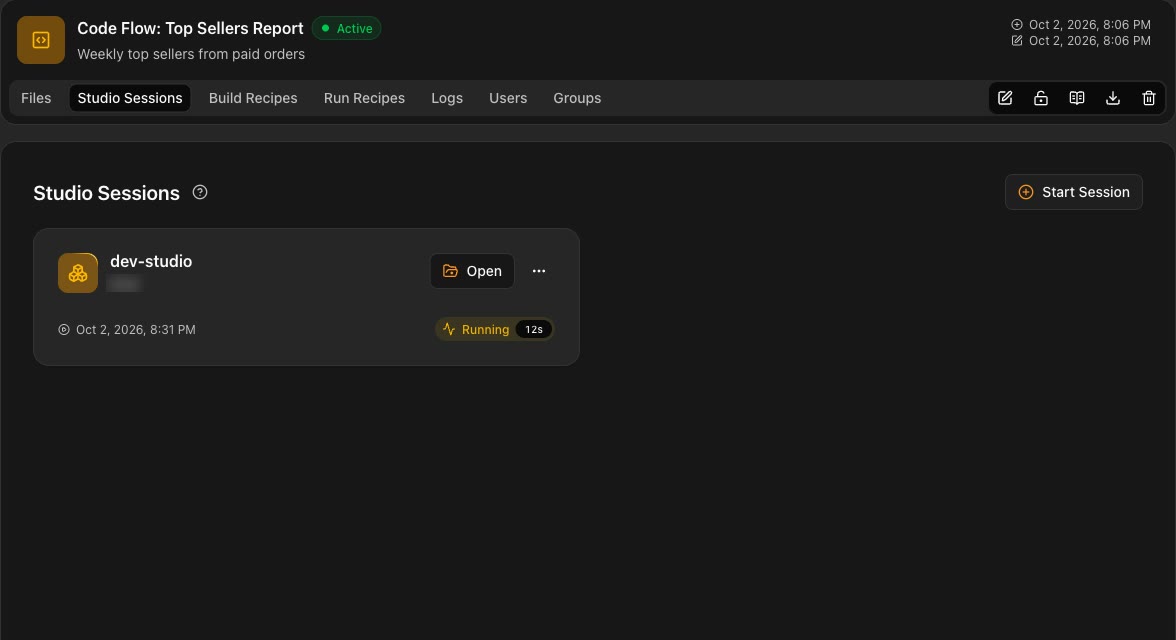
Makine öğrenmesi için öznitelik hazırlığı, özel entegrasyonlar ya da tuvalin kapsamadığı her şey için Jupyter Lab'de Python yazın, bunu bir imaj olarak paketleyin ve aynı bağlantılar ve erişim kurallarıyla kendi Kubernetes kümenizde çalıştırın.
Stüdyoda yazın
Projeye atanmış bir Stüdyoda Jupyter Lab oturumu açın. Saklamak istediğiniz dosyaları Kod Akışına kaydedin.
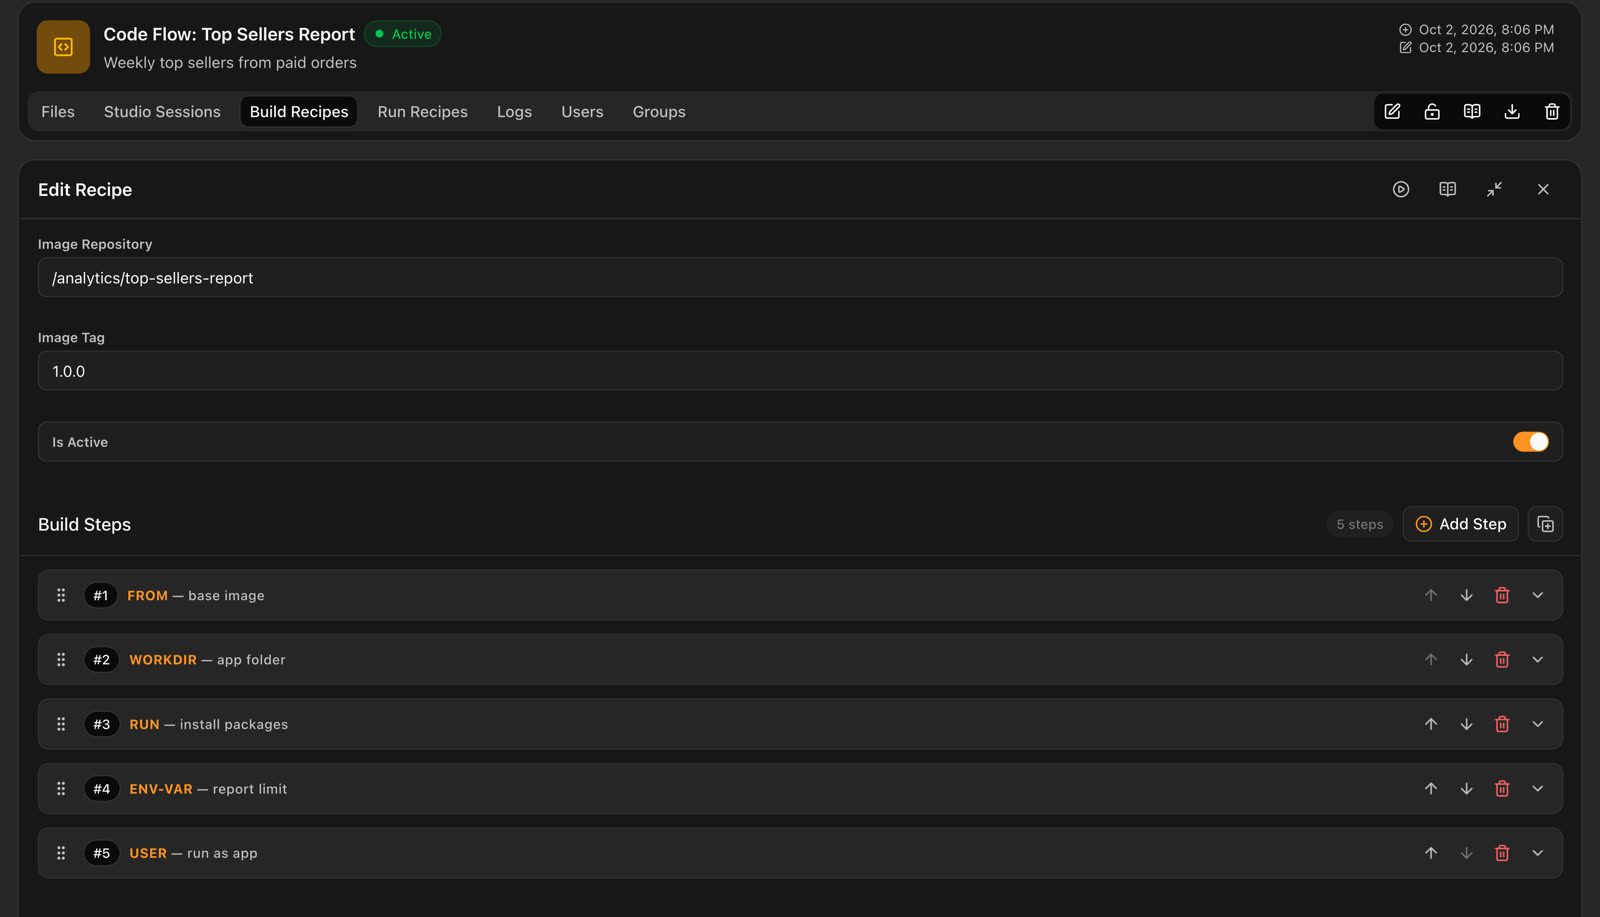
Paketleyin
İmaj deposunu ve etiketini belirleyin, ardından derleme adımlarını sıralayın. Kendi sunucunuzdaki bir ajan imajı derler ve günlüğü canlı olarak geri gönderir.
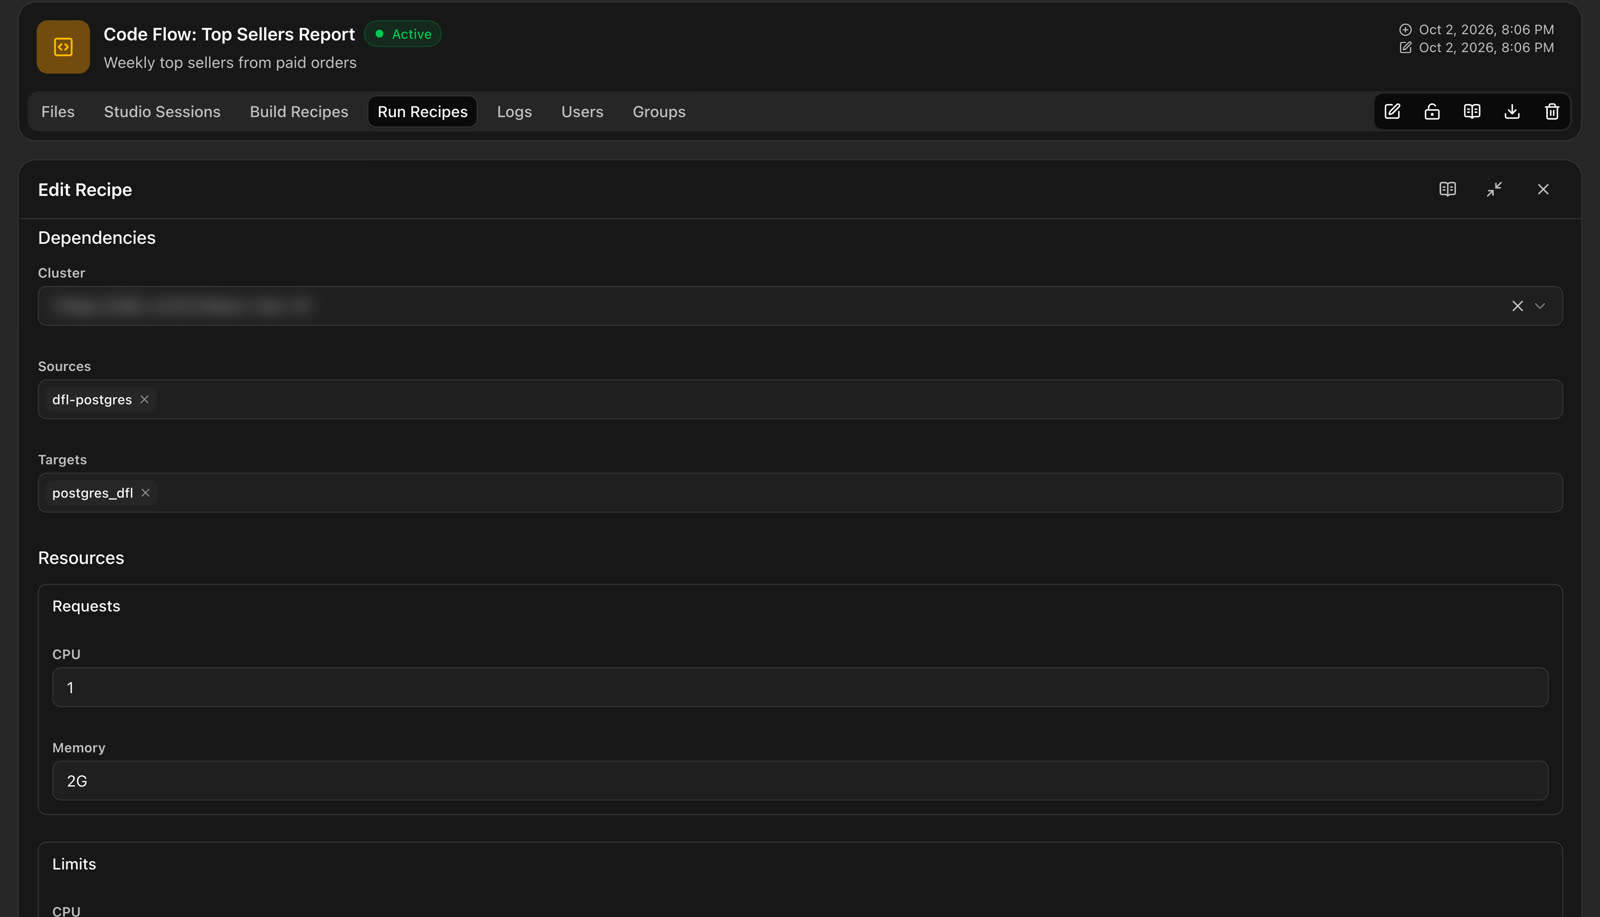
Kümenizde çalıştırın
Kümeyi, projenin kaynak ve hedeflerini, ortam ve gizli bilgi ayarlarını, CPU ve bellek istek ve limitlerini seçin.
Kataloglayın, sorgulayın, kimin göreceğini belirleyin.
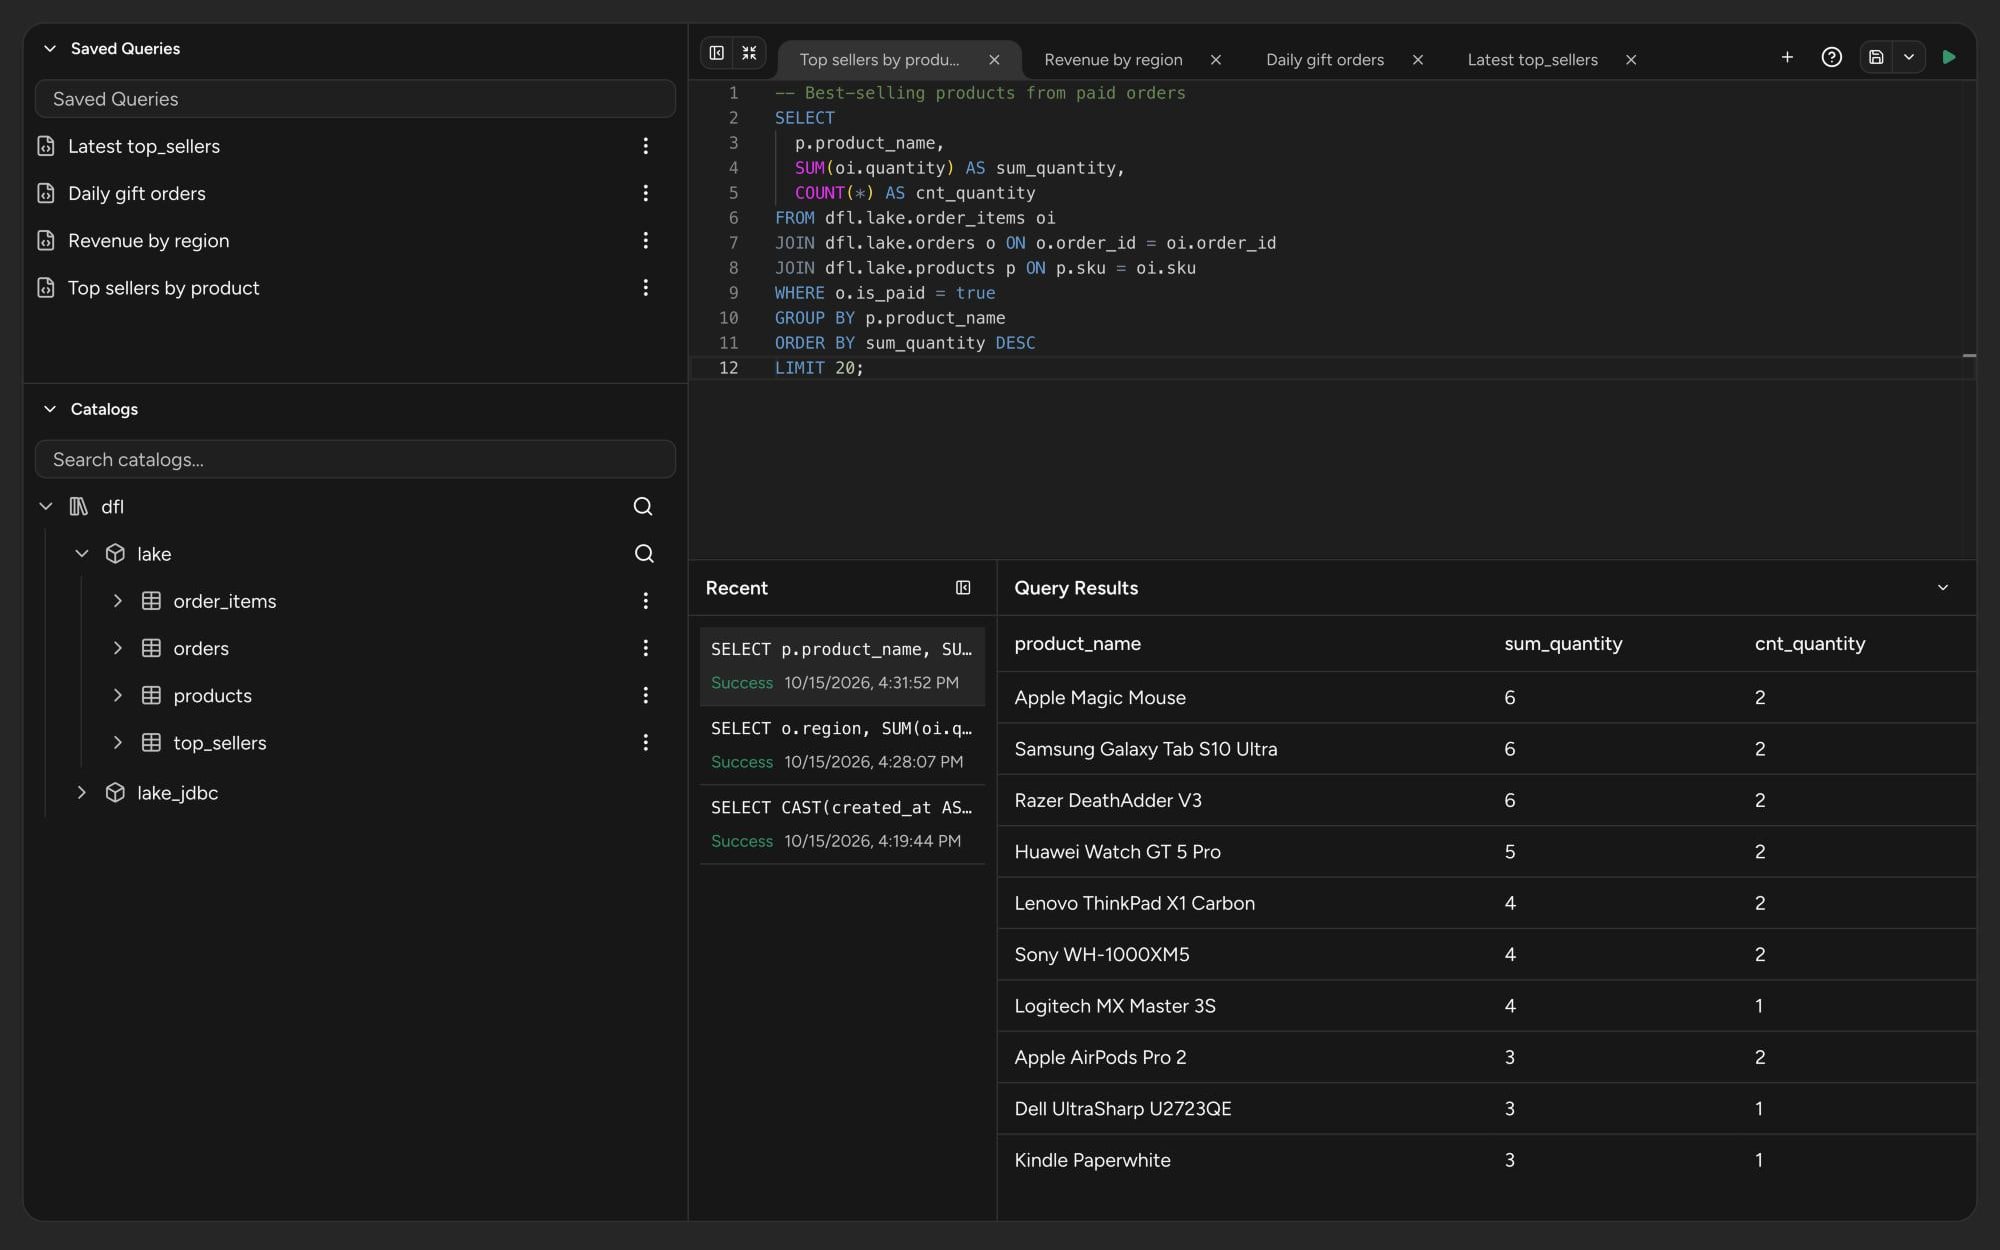
Iceberg, Parquet ve diğer açık formatlardaki lakehouse tablolarınız kataloglarda düzenlenir, aynı çalışma alanından sorgulanabilir ve yapay zekâ projelerini beslemeye hazırdır. Analistler şemaları gezer, SQL'i seçtiğiniz motorda çalıştırır ve yalnızca rollerinin izin verdiği tabloları görür.
- Sekmeler ve kayıtlı sorgular. Aynı anda birden fazla sekmede çalışın, tekrar kullandığınız sorguları kaydedin, önceki çalıştırmaları Son Sorgular altında bulun.
- Sonuçlar geldikçe. Sorgu çalışırken satırlar sonuç paneline akar ve sorguyu istediğiniz an durdurabilirsiniz.
- Kataloglar. JDBC veya dosya alanlarında Iceberg, Parquet, CSV, ORC ve JSON tabloları. Bir kaynaktan toplu tablo oluşturun ve kolonlarını değiştirin.
- Tablo düzeyinde erişim. Politikalar, roller ve izinler her tabloyu kimin okuyabileceğini belirler.
İşlemeyi Spark yapar. Ölçeklemeyi Kubernetes yapar.
Worker sayıları, boşta kalma süreleri, node selector ve toleration ayarlarıyla Kubernetes kümeleri ve Stüdyo çalışma alanları. Yapılandırma profilleri ortak değişkenleri ve gizli bilgileri tek yerde tutar.
Bir işi, Kod Akışını, projeyi, klasörü ya da tüm bir alanı dosyaya aktarın ve başka bir ortama içe aktarın.
Seçtiğiniz her altyapıda çalışır. Verileriniz orada kalır.
DataFloem cloud-native'dir ve Kubernetes'in çalıştığı her yerde çalışır: AWS, Azure, Google Cloud, özel bir bulut ya da kendi veri merkeziniz. Onu okuduğu sistemlerin yanına kurarsınız; böylece verileriniz ve kimlik bilgileriniz ortamınızdan asla çıkmaz.
- Sizin işlem gücünüzİşler, kısmi çalıştırmalar ve Stüdyo oturumları, belirlediğiniz CPU ve bellek limitleriyle sahibi olduğunuz Kubernetes kümelerinde çalışır.
- Sizin derleme zincirinizSunucularınızdaki bir derleme ajanı Kod Akışlarını paketler ve imajları kendi deponuza gönderir.
- Sizin bağlantılarınızBağlantılar SSL/TLS kullanır. Parolalar ve gizli sürücü seçenekleri üründe maskeli kalır.
İlk bağlantıdan itibaren yönetişim altında.
Kataloglar, şemalar, erişim kuralları ve denetim günlükleri her tablonun bağlamını korur. Erişim, kurumunuzun yapısını izler: her iş, Kod Akışı ve bağlantı bir projede yer alır ve her projenin kendi kullanıcıları ve grupları vardır.
Net bir hiyerarşi
Alanlar klasörleri, klasörler projeleri, projeler de işi barındırır. Altyapı bir projeye atanır ya da bir kişi talep eder ve sahibi bu talebi bir görev olarak onaylar.
alan analytics
└ klasör commerce
  └ proje revenue
    ├ işler · kod akışları
    ├ kaynaklar · hedefler
    ├ kümeler · stüdyolar
    └ kullanıcılar · gruplar
Her kaynakta erişim kontrolü
Her iş, Kod Akışı, bağlantı ve kümenin kendi kullanıcıları ve grupları vardır; listeleme, okuma, değiştirme, çalıştırma, kullanma, silme ve paylaşma hakları ayrı ayrı verilir.
Kendi dizin servisiniz ya da kimlik sağlayıcınızla oturum açın.
Kimin ne yaptığının kaydı
Saklama süresini sizin belirlediğiniz, kaynak tipi bazında açılan istek ve değişiklik denetim günlükleri.
Açık işler tuvalde başka kimlerin olduğunu gösterir. İlk düzenleme kilidi alır, diğerleri işi salt okunur görür ve bir yönetici unutulmuş bir kilidi kaldırabilir.
Veri ekiplerinin bize sorduğu sorular.
Sorunuzu bulamadınız mı? info@datafloem.com adresine yazın, yanıtlayalım.
Verilerim nereye gidiyor?
Ağınızın dışına hiçbir yere. DataFloem kurum içinde çalışır: onu kendi veri merkezinize ya da kendi bulut hesabınıza kurarsınız. İşler sistemlerinizden doğrudan okur ve onlara doğrudan yazar; verileriniz ve kimlik bilgileriniz ağınızın içinde kalır.
İşlerimi ne çalıştırıyor?
DataFloem'e tanımladığınız Kubernetes kümeleri. Her çalıştırma, seçtiğiniz kümeye o kümenin izin verdiği kaynaklarla gider. İfadeler Spark söz dizimiyle yazılır.
Düğüm çizmek yerine kod yazabilir miyim?
Evet, iki düzeyde. Bir işin içinde SQL ve Python düğümleri tek bir adımı kod olarak yazmanıza ve çıktısını tanımlamanıza izin verir. Tamamen kodla yazılan bir akış için Kod Akışı; Jupyter Lab veya VS Code oturumundaki dosyaları, onları paketleyen bir Yapılandırma Tarifini ve kümenizde çalıştıran bir Çalıştırma Tarifini bir arada tutar.
Kaynak tablo değiştiğinde ne olur?
DataFloem her düğümün kaydedildiği andaki kolonları şimdiki girdisiyle karşılaştırır. Yalnızca yeri değişen kolon kimlikleri onarılır. Çıktısı değişebilecek düğümler, kolonları adıyla belirten bir inceleme işareti alır ve bunları eklemeye ya da dışarıda bırakmaya bir kişi karar verir. İncelemeler açıkken tam çalıştırma sizi uyarır.
İşin tamamını çalıştırmadan önce sonuçları kontrol edebilir miyim?
Evet. İlgilendiğiniz düğümleri seçip yalnızca onları çalıştırın, ardından herhangi bir düğümün satırlarını Veri Önizleme'de açın: filtreleyin, sıralayın ve sayfalar arasında gezinin. Son çalıştırmadan bu yana ayarları, bağlantıları veya öncülleri değişen düğümler güncel değil olarak işaretlenir.
Çalışmayı geliştirme ortamından canlıya nasıl taşırım?
Bir işi, Kod Akışını, projeyi, klasörü ya da tüm bir alanı dosyaya aktarın ve diğer ortama içe aktarın. Akış parametreleri, ortamdan ortama değişen değerleri işin kendisinin dışında tutar.
Birden fazla mühendis aynı iş üzerinde nasıl çalışır?
Açık bir işteki herkes orada başka kimlerin olduğunu görür. İlk düzenleme kilidi alır ve diğerleri kilit kalkana kadar işi salt okunur görür; bir yönetici unutulmuş bir kilidi kaldırabilir. Her iş numaralı versiyonlar tutar.
Kullanıcılar nasıl oturum açar, kim neyi görebilir?
Kullanıcılar LDAP veya kimlik sağlayıcınızla oturum açar: Okta, Microsoft, Google ya da Keycloak. Her kaynağın kendi kullanıcıları ve grupları vardır; listeleme, okuma, değiştirme, çalıştırma, kullanma, silme ve paylaşma hakları ayrı ayrı verilir. Katalog politikaları tek bir tabloya kadar iner.
DataFloem nasıl lisanslanıyor?
Developer Edition ücretsiz ve çok yakında yayında: kurulum ekranından e-postanızla kayıt olacaksınız. Enterprise Edition, kurumunuz için özellikleri ve limitleri belirleyen bir lisans kullanır; yöneticiler lisansı ürün içinden yükler, yeniler ve iptal eder.
Ücretsiz başlayın. Enterprise ile büyüyün.
İki sürüm de sizin altyapınızda çalışır ve verinizi açık formatlarda tutar. Yayınlandığında Developer Edition ile başlayın; platformunuz büyüdükçe Enterprise'a geçin.
Başlamak ücretsiz
Kendi kurulumunuzda ücretsiz olarak işler ve Kod Akışları oluşturun. Neredeyse hazır: e-postanızı bırakın, yayınlandığı gün size haber verelim.
Developer Edition hakkındaPlatformun tamamı, kurumunuzun ölçeğinde
Lisansınız özellikleri ve limitleri belirler: kullanıcılar, alanlar, kümeler, CPU ve bellek, saklama süresi. Yöneticiler lisansı ürün içinden yükler, yeniler ve iptal eder.
- LDAP ve tek oturum açma
- İstek ve değişiklik denetim günlükleri
- Kendi sunucularınızda derleme ajanları
- Katalog erişim politikaları
Verinize bir şekil verin.
DataFloem'in kaynaklarınıza, altyapınıza ve ekibinize nasıl uyduğunu görün. Platformu, kendi kurumunuzdan bir kullanım senaryosuyla birlikte adım adım inceleyelim.