Okunabilen birleştirmeler.
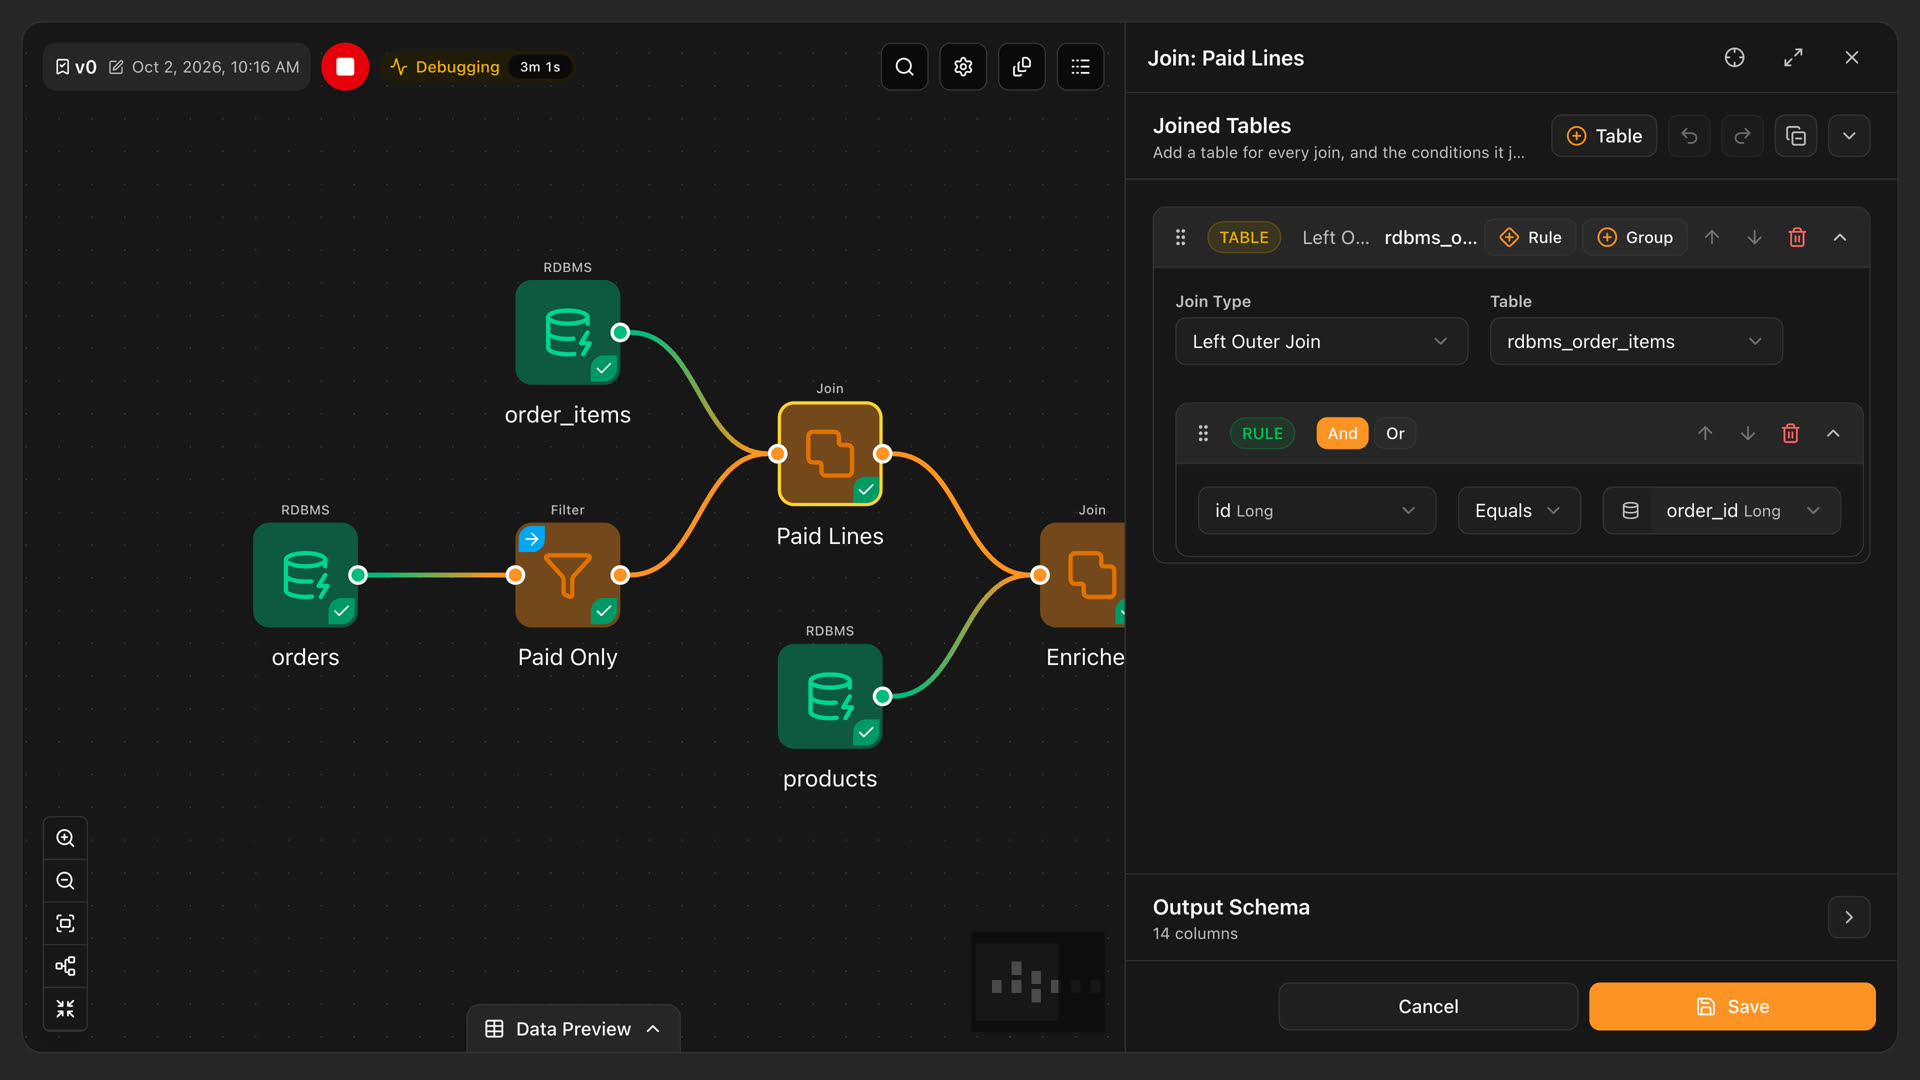
Bir tablo ekleyin, birleştirme tipini seçin ve koşulu kurallar ile gruplardan oluşturun. Her kolon adının yanında tipini gösterir; böylece bir anahtar uyumsuzluğu motora ulaşmadan görünür.
DataFloem, Apache Spark ve Kubernetes üzerine kurulu bir veri platformudur. Kaynaklarınızı bağlar, veriyi görsel işlerle ya da kodla şekillendirir, bunları kendi kümelerinizde çalıştırır, sonuçları yönetilen kataloglarda tutar ve kimin ne yaptığını kaydeder. Her katmanın ne yaptığı aşağıda.
Enterprise işaretli özellikler Enterprise Edition lisansıyla gelir. Sürümleri karşılaştırın
Dağınık sistemleri tek bir yerde toplayın: eski veri tabanlarından nesne depolamaya, lakehouse kataloglarına ve NoSQL'e kadar. Her bağlantı bir kez eklenir, test edilir ve yalnızca ihtiyaç duyan projelerle paylaşılır.
PostgreSQL, Oracle, SQL Server, MySQL, Teradata, Vertica, ClickHouse, Trino, Azure SQL ve Azure Synapse.
Google Cloud hizmet hesabıyla bağlanan BigQuery.
Amazon S3 ve MinIO, Ceph gibi S3 uyumlu depolar; path-style erişim ve seçtiğiniz bir kök dizinle.
Microsoft Entra ID üzerinden Azure Blob Storage ve Data Lake Storage Gen2, hizmet hesabı üzerinden Google Cloud Storage.
MongoDB ve Elasticsearch; sunucu istediğinde SSL/TLS ile.
Iceberg REST, JDBC ve dosya katalogları; böylece tablolarınız her motorun okuyabildiği açık formatlarda kalır.
Bir iş, tuval üzerinde Apache Spark ile çalışan bir akıştır: kaynaklar, dönüşümler ve hedefler. Ekipler yeni entegrasyonları sıfırdan yazmadan kurar; her düğüm tiplendirilmiş bir form açar, böylece hatalar iş çalışırken değil, siz kurarken ortaya çıkar.
Bir tablo ekleyin, birleştirme tipini seçin ve koşulu kurallar ile gruplardan oluşturun. Her kolon adının yanında tipini gösterir; böylece bir anahtar uyumsuzluğu motora ulaşmadan görünür.

Her iş versiyonlar tutar; her biri tuvalinin tam bir kopyasıdır. Varsayılan versiyon çalışmaya devam ederken akışı güvenle değiştirin; her versiyonu kimin oluşturduğunu ve hangi versiyondan türediğini görün.
Herhangi bir alanda $$name olarak kullanılan sabit ya da ifade değerleri. İfadeler iş çalıştığında hesaplanır.
Bir adımı çizmek yerine yazmak daha kolaysa, onu bir sorgu ya da Python betiği olarak yazın ve çıktısını tanımlayın.
Her çalıştırma, her adımın durumunu, mesajını, deneme sayısını ve süresini, başarısız olduğunda da hata yığınını raporlar. Bir adıma tıklayın, düğümünü bulun.
Bir işi ilk düzenleyen kişi onu kilitler; böylece ekip arkadaşları birbirlerinin çalışmasının üzerine asla yazmaz. Kilidi yalnızca sahibi ya da bir yönetici kaldırabilir.
Yeni bir işe başlamak için bir işi kopyalayın ya da bir işi veya tek bir versiyonunu dosyaya aktarıp başka bir ortama içe aktarın.
Dokümanlardaİşler Versiyonlar Parametreler Çalıştırma günlükleri Kilitli işler
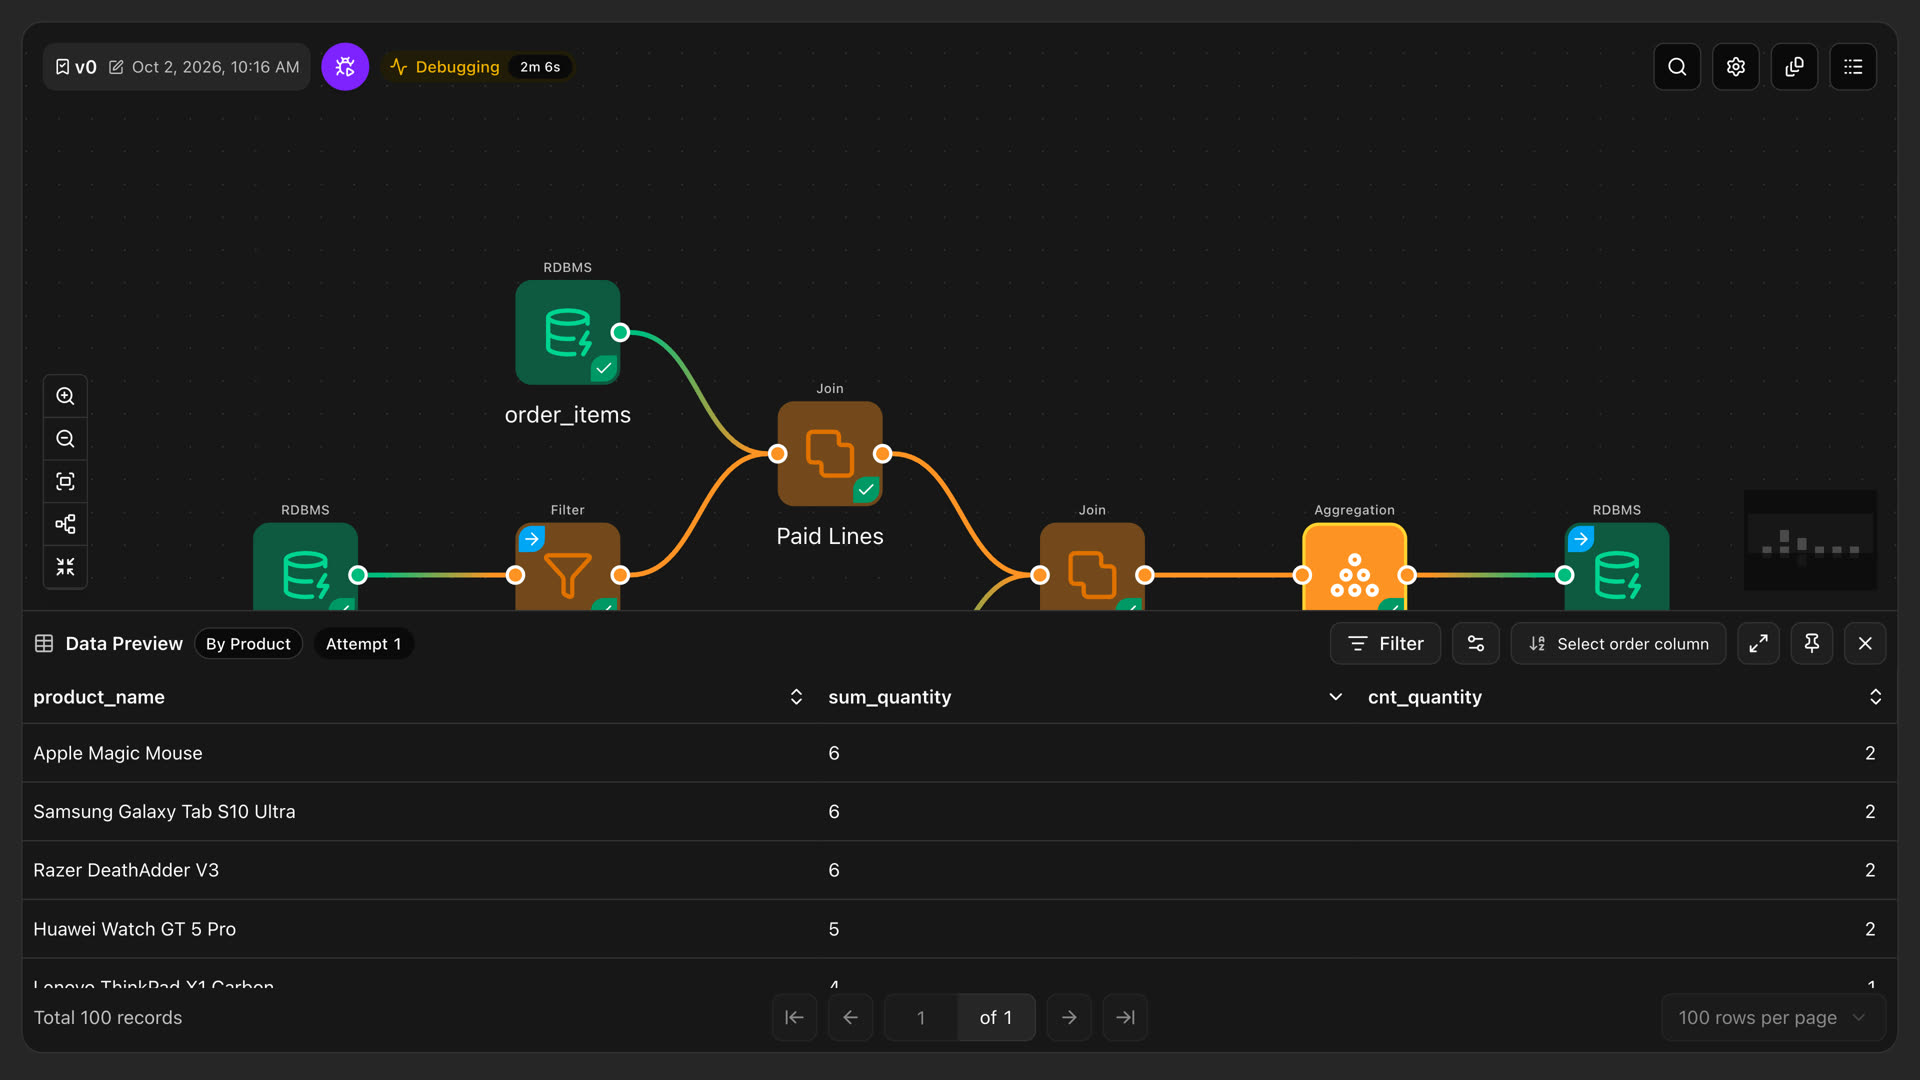
İşi üzerinde çalıştığınız düğüme kadar çalıştırın ve satırlarını yerinde açın. Tuvalden ayrılmadan sonucu filtreleyin, sıralayın ve sayfalar arasında gezinin.

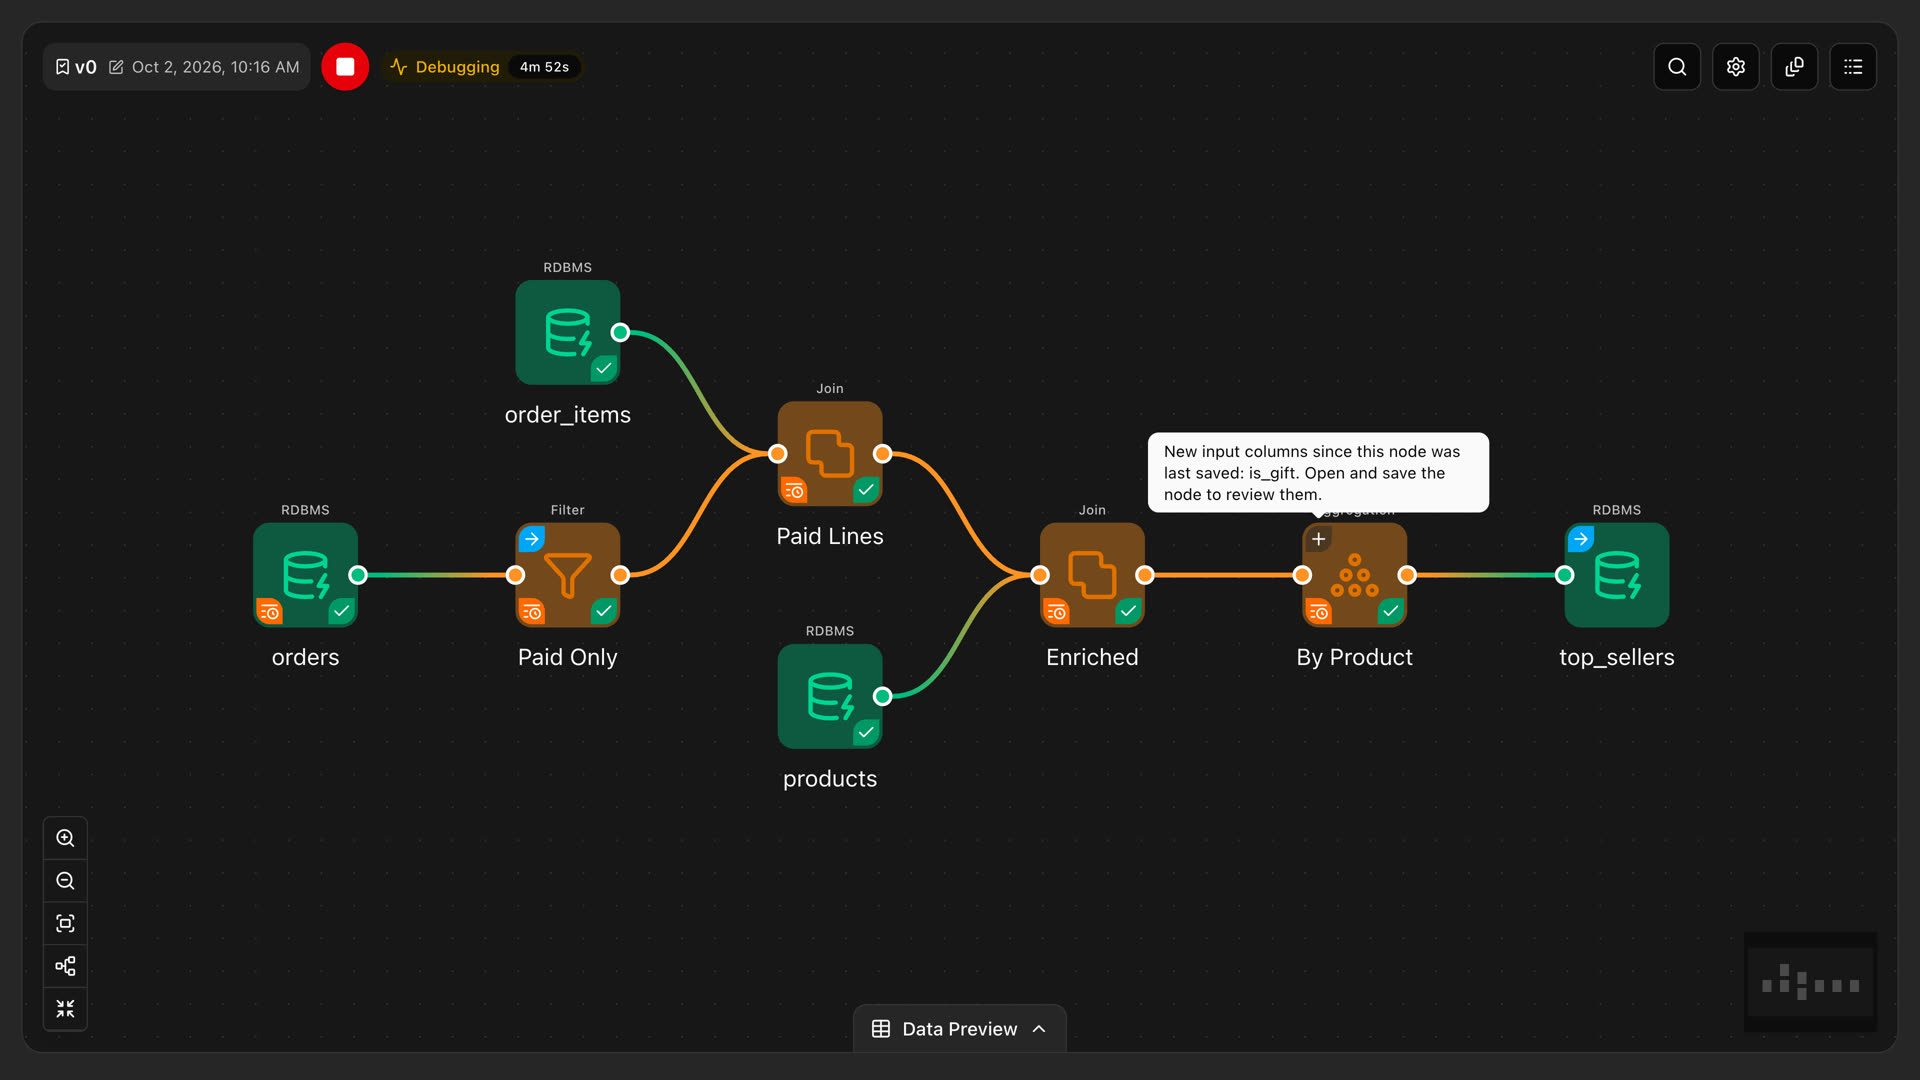
Onlarca kaynak kendi takvimine göre değişirken şema değişiklikleri günlük bir gerçektir. Her düğüm kaydedildiği andaki kolonları hatırlar; bir kaynağa kolon eklendiğinde, kaynaktan kolon çıkarıldığında ya da kolonun tipi değiştiğinde DataFloem yalnızca değişikliğin ulaştığı düğümleri işaretler.
Bir kolonun yalnızca yeri değiştiyse DataFloem referansı sizin için düzeltir. Çıktısı değişebilecek düğümler, kolonları tam adıyla belirten bir işaret alır.
Yalnızca yeri değişen kolon kimlikleri sizin için onarılır. Anlamı değişebilecek düğümler, ipucunda tam kolon adlarıyla birlikte bir işaret alır.
Düğümü açın ve seçin: yeni kolonları çıktıya ekleyin ya da dışarıda bırakın. İncelemeler açıkken tam çalıştırma sizi uyarır.

Makine öğrenmesi için öznitelik hazırlığı, özel entegrasyonlar ya da tuvalin kapsamadığı her şey için Jupyter Lab'de Python yazın, bunu bir imaj olarak paketleyin ve işlerinizle aynı bağlantılar ve erişim kurallarıyla kendi Kubernetes kümenizde çalıştırın.


Python betiklerini ve ihtiyaç duydukları dosyaları Stüdyo oturumundan doğrudan Kod Akışına kaydedin.
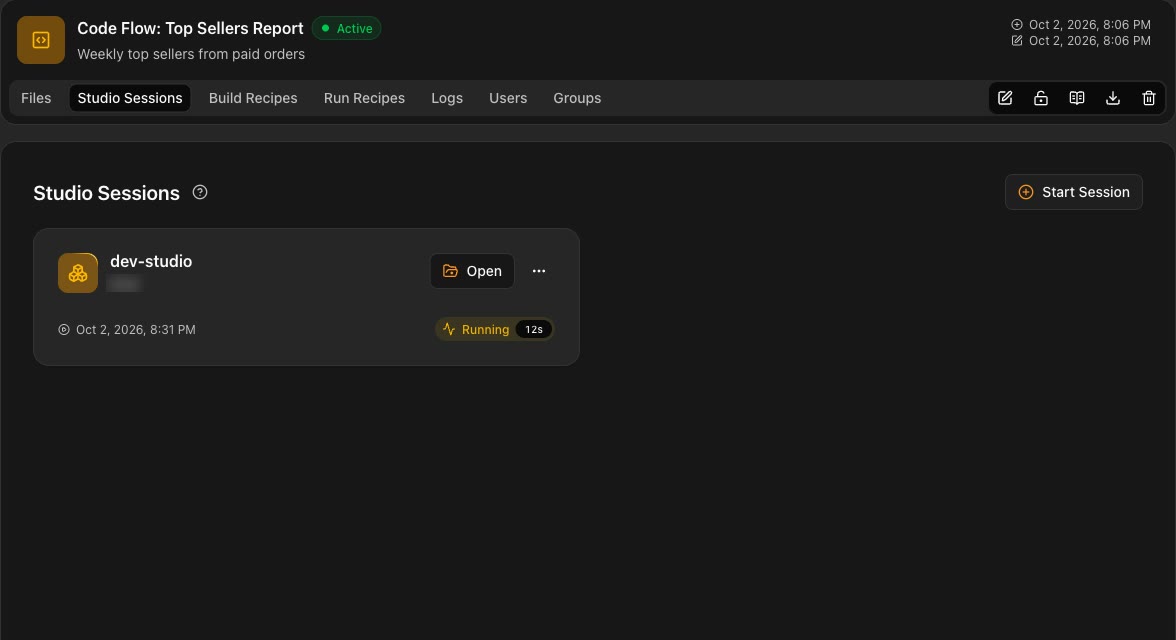
Bir kümede Jupyter Lab başlatın ve Kod Akışının yanında açın; böylece veri bilimciler bildikleri araçlarla çalışır.
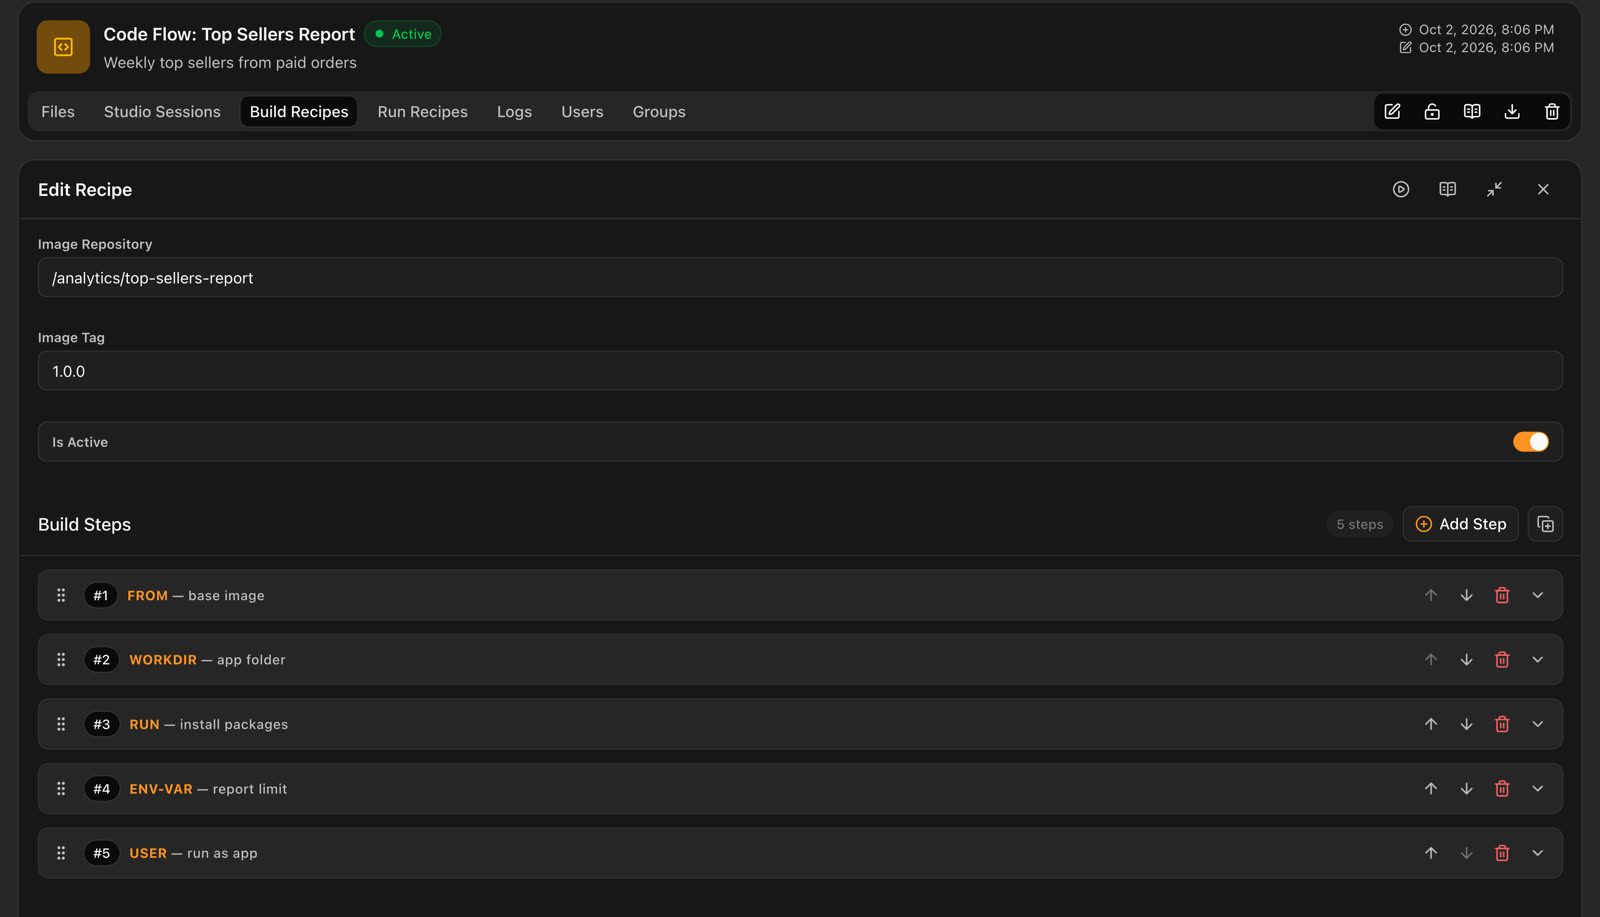
Kodunuzu sıralı adımlarla bir konteyner imajı olarak paketleyin; imajı kendi sunucunuzdaki bir ajan derler, böylece kodunuz ortamınızdan asla çıkmaz.
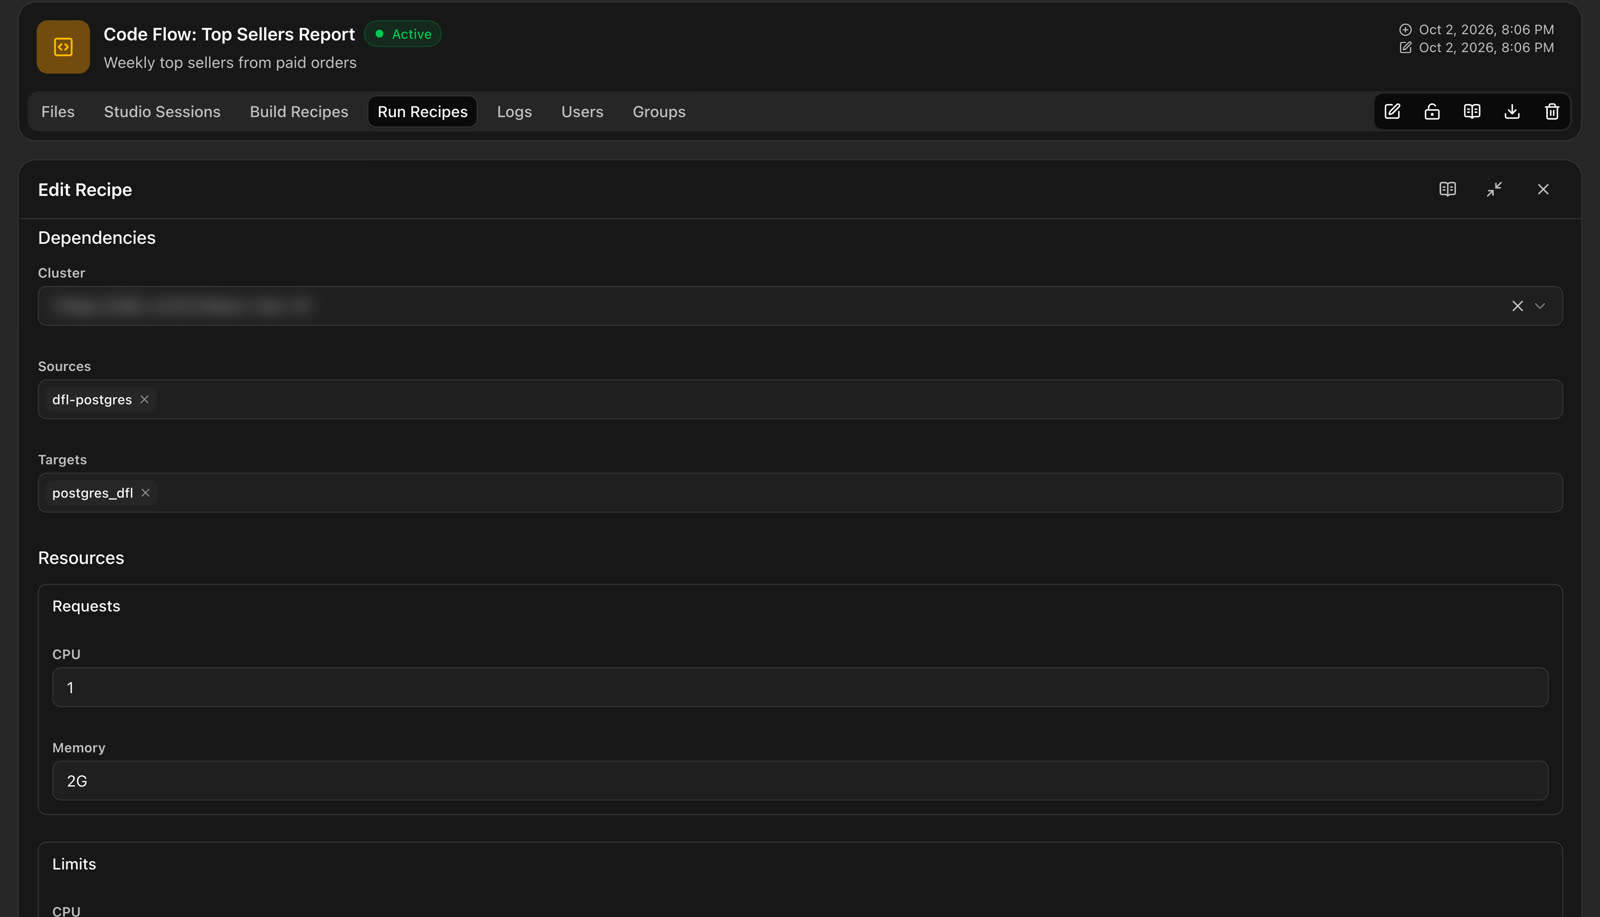
Derlenmiş bir imajı; projenin kaynak ve hedefleri, ortam değişkenleri, CPU ve bellek istek ve limitleriyle bir kümede çalıştırın.
Ajan derlemeleri, Stüdyo oturumları ve çalıştırmalar, durumları ve süreleriyle birer günlük tutar.
Bir Kod Akışı da bir iş gibi ilk düzenlemede kilitlenir; kilidi sahibi ya da bir yönetici kaldırana kadar öyle kalır.
DokümanlardaKod Akışı dosyaları Stüdyo oturumları Yapılandırma Tarifleri Çalıştırma Tarifleri Kod Akışı günlükleri
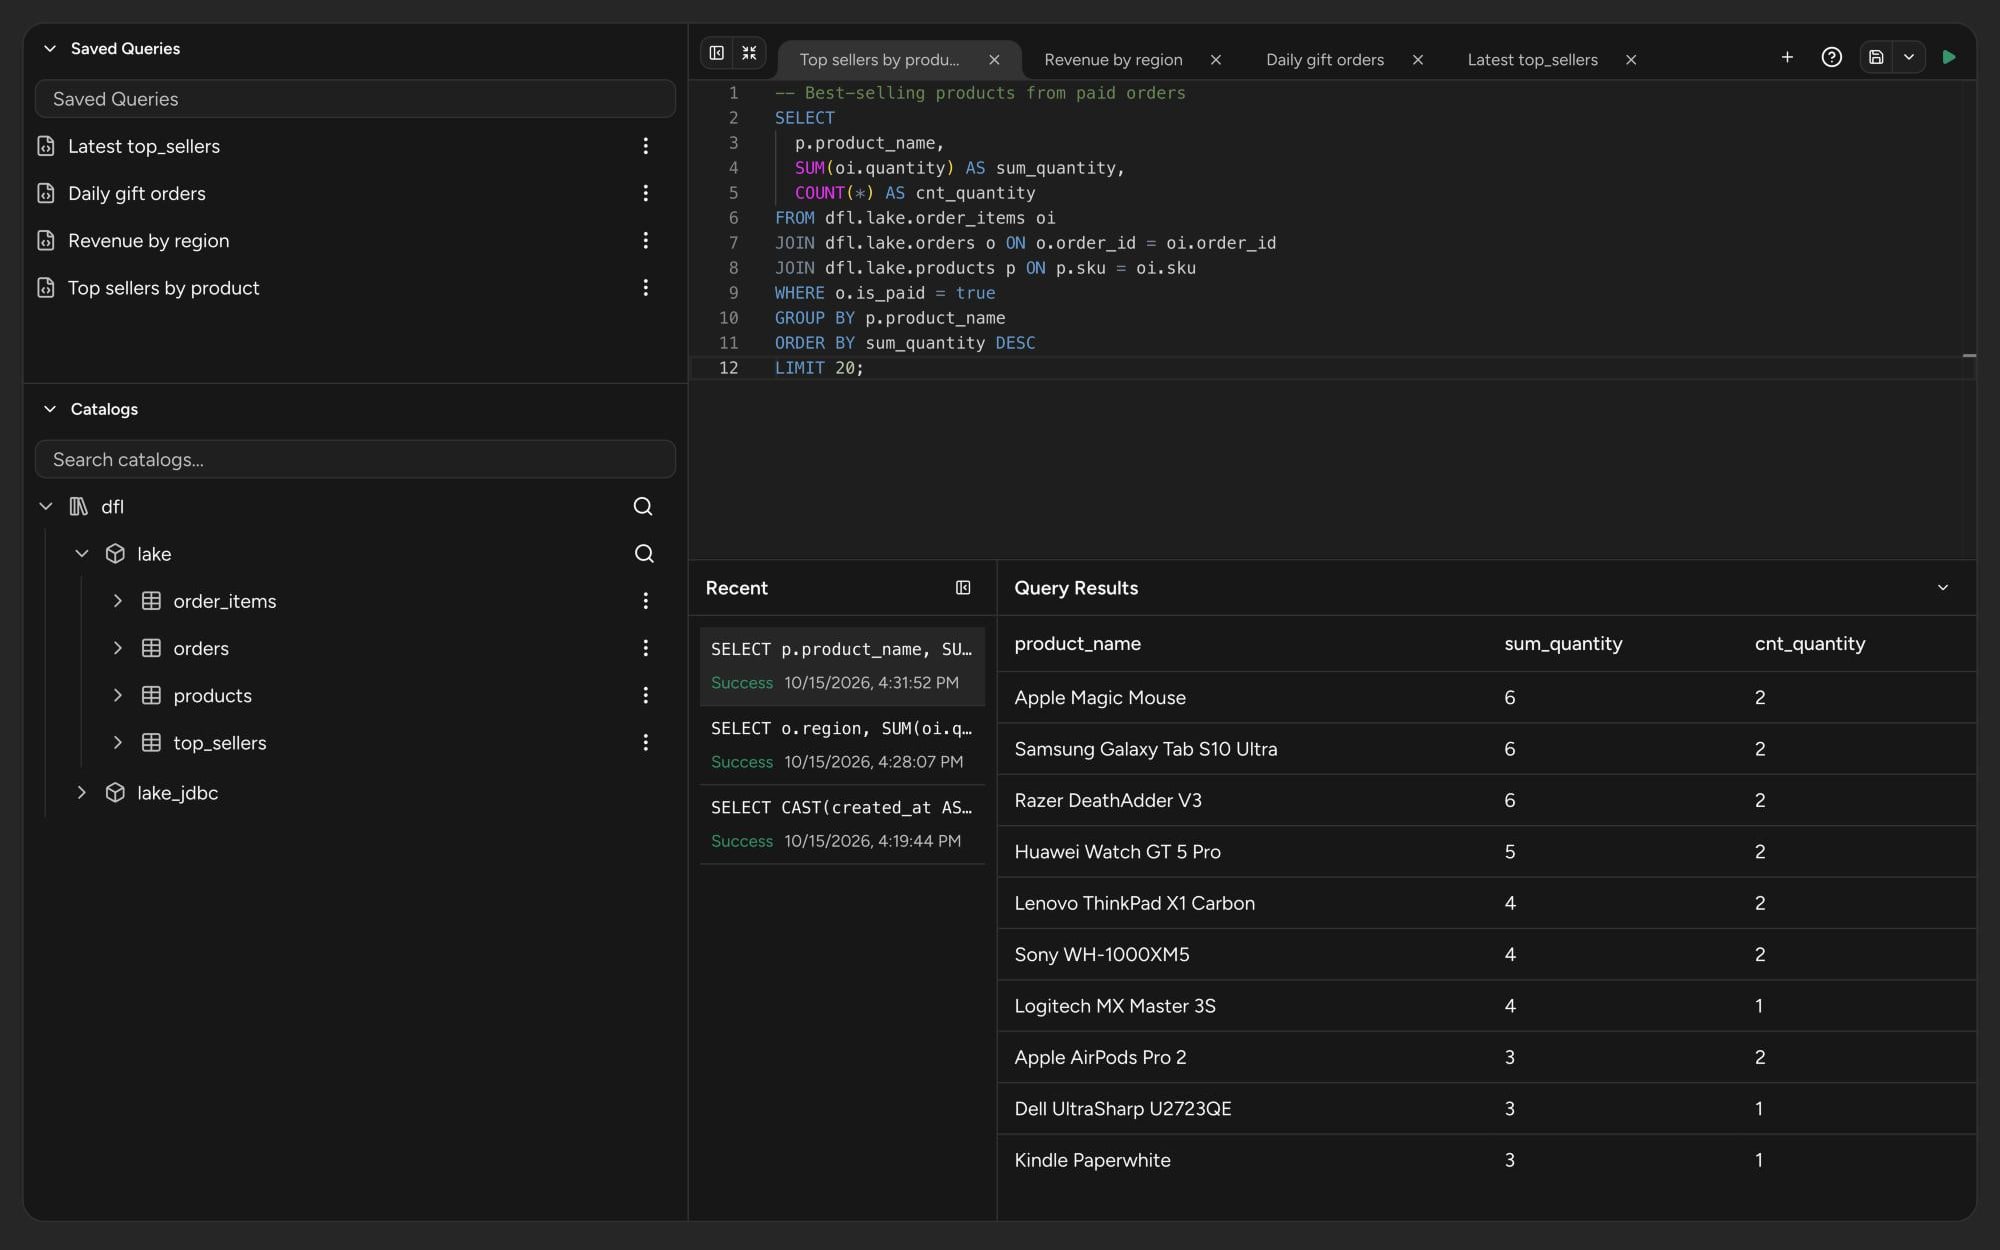
Analistler ve mühendisler aynı yönetilen tabloları aynı çalışma alanından sorgular. Katalogları bir ağaçta gezin, bir tabloyu yeni sekmede açın ve sorguyu seçtiğiniz kümede çalıştırın.

DokümanlardaSQL sorguları
Tablolarınız Iceberg gibi açık formatlarda tutulur; işlerin yazdığı, analistlerin sorguladığı ve yapay zekâ projelerinin beslendiği kataloglarda düzenlenir. Erişim kuralları her kataloğu, alan adını ve tabloyu kimin görebileceğine karar verir.
Her kataloğu Iceberg REST üzerinden sunun; böylece diğer motorlar da aynı tabloları okuyabilir. Sıkıştırma ve snapshot temizliği tabloları hızlı tutar; her katalog için varsayılan bir warehouse belirlenir.
Her biri kendi özellikleriyle bir bağlantı üzerinde çalışan dosya veya JDBC alan adları.
Formatı, konumu ve sizin kurduğunuz şemasıyla dosya tabloları; bir kaynaktan seçilen, birden fazlası bir kerede eklenebilen JDBC tabloları.
Bir katalogda, alan adında ya da tabloda işlemlere izin verin veya reddedin; joker karakterler ve çakışmaları çözen bir öncelikle.
Politikaları, ekiplerinizin çalışma biçimine uyan rollerde toplayın.
Bir rolü bir kullanıcıya ya da bir gruba verin.
DokümanlardaKataloglar Katalog alan adları Katalog tabloları Politikalar Roller İzinler
DataFloem cloud-native'dir ve kendi altyapınızda barındırılır. Onu Kubernetes'in çalıştığı her yere kurun: genel bulut, özel bulut ya da kendi veri merkeziniz. İşler kümeleriniz genelinde Apache Spark üzerinde çalışır, iş yüküyle birlikte ölçeklenir; verileriniz ve kimlik bilgileriniz ortamınızdan asla çıkmaz.
İş yüküyle birlikte ölçeklenen ve boşta kalınca duran dinamik kümeler; böylece yalnızca çalışan kaynak için ödersiniz. Sabit yükler için statik kümeler. Her pod'un imajını, CPU ve belleğini belirleyin.
Bir üst profilden miras alan ve yalnızca farklı olanı değiştiren, ortak değişken ve gizli bilgi profilleri.
Kendi CPU ve belleğiyle, NGINX veya Traefik ingress arkasında çalışan Jupyter Lab veya VS Code çalışma alanları.
Kümelerinizin ve Çalıştırma Tariflerinizin kullandığı imajlar; özel, herkese açık ya da bulut kayıt defterlerinden.
Kendi sunucularınızdaki ajanlar Kod Akışı imajlarını derler ve günlüğü çalışırken canlı olarak geri gönderir.
Kümeler ve Stüdyolar onları kullanan projelere atanır ya da bir görev olarak talep edilip onaylanır.
DokümanlardaKümeler Küme yapılandırmaları Stüdyolar İmajlar Ajanlar
Alanlar klasörleri, klasörler projeleri, projeler de işi ve işin kullanabileceği kaynakları barındırır. Her modülün kullanıcılar ve gruplar için kendi yetkileri vardır.
Ortamları, ekipleri ya da müşterileri birbirinden ayırın. Yeni kullanıcılar ve ilk kez giriş yapan LDAP veya SSO kullanıcıları varsayılan alanda başlar.
Bir proje; işlerini, Kod Akışlarını ve SQL sorgularını, kendisine atanan kaynak, hedef, katalog, küme ve Stüdyolarla bir araya getirir.
Her modül için kullanıcılara ve gruplara görüntüleme, oluşturma, değiştirme, silme ve erişim yönetme hakkı verin. Bir kullanıcının hakları, gruplarının haklarının toplamıdır.
LDAPS veya StartTLS üzerinden kendi dizin servisinizle oturum açın; grup eşleme ve izinli gruplar listesiyle. Parolalar asla saklanmaz.
OpenID Connect üzerinden Google, Okta, Microsoft Entra ID veya Keycloak. Kullanıcılar ilk girişlerinde oluşturulur.
Bir erişim talebi, onu onaylayan grup için bir görev olur ve Tamamlandı ya da Reddedildi olana kadar Yapılacak olarak kalır.
DokümanlardaAlanlar Projeler Kullanıcılar Gruplar LDAP ayarları SSO sağlayıcıları Görevler
DataFloem'e yapılan her istek ve verisindeki her değişiklik kayda geçer; uyumluluk denetimlerine hazırdır. Neyin ne kadar süre izleneceğine siz karar verirsiniz.
Her API isteği; kullanıcı, uç nokta, durum kodu ve zamanıyla.
DataFloem'in kendi verisindeki her ekleme, güncelleme ve silme, koleksiyon koleksiyon.
Günlükleri 0 ile 730 gün arasında saklayın ve her modül için günlük tutmayı açıp kapatın.
Kilitli işler ve Kod Akışları tek bir yerde listelenir; bir yönetici unutulmuş bir kilidi oradan kaldırabilir.
DokümanlardaDenetim günlükleri Değişiklik günlükleri Günlük ayarları Kilitli işler
Bir demo talep edin; tuvaldeki işlerden Kod Akışlarına kadar sizin için önemli olan kısımları ekibinizle birlikte inceleyelim.